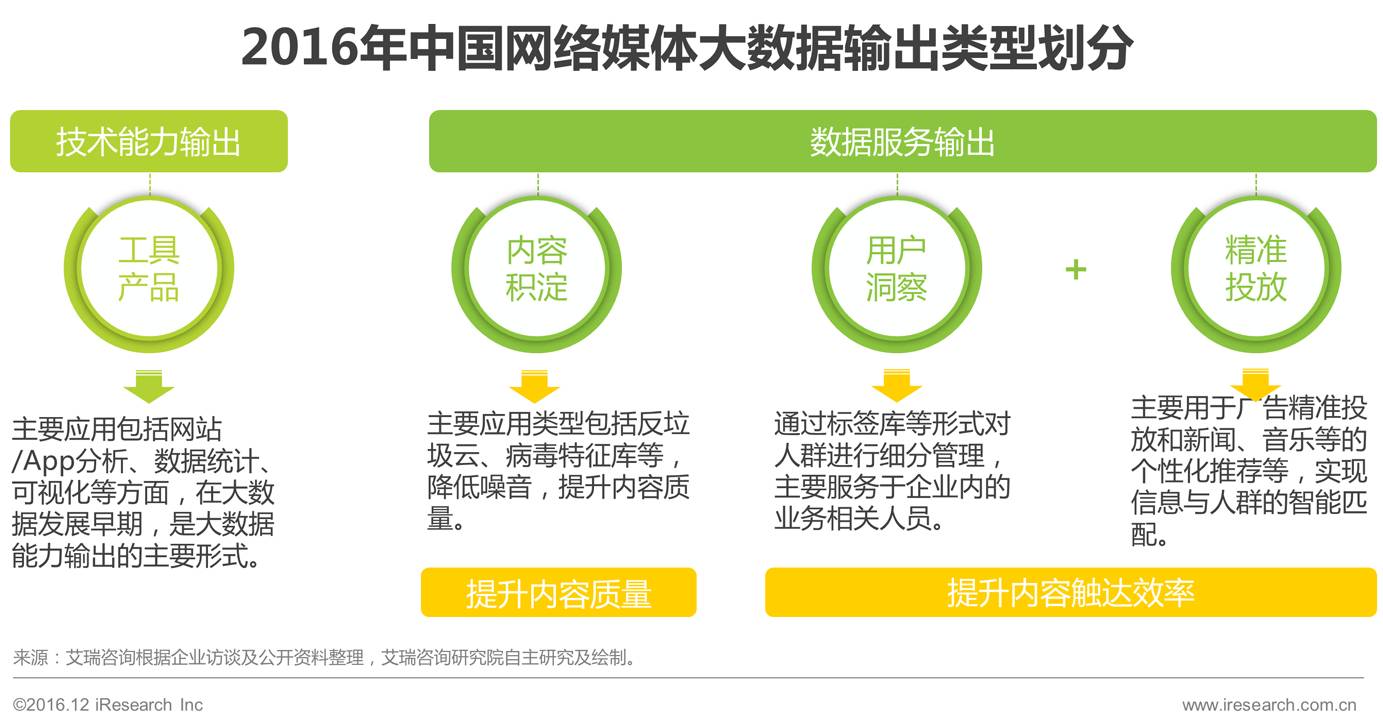
大数据运维在互联网数据服务中的关键作用
在当今数字化时代,互联网数据服务已成为企业运营和用户生活的重要组成部分。随着数据量的爆炸式增长,大数据运维(Big Data Operations)作为保障数据服务稳定、高效运行的核心环节,其重要性日益凸显。本文将探讨大数据运维在互联网数据服务中的应用、挑战及最佳实践。
一、大数据运维概述
大数据运维是指对大数据平台(如Hadoop、Spark、Flink等)进行规划、部署、监控、优化和故障处理的一系列活动。其目标是确保数据采集、存储、计算和展示的全链路高可用、高性能和高可扩展性。与传统运维相比,大数据运维面对的是分布式系统、海量数据和复杂组件,因此需要更专业的技能和工具。
二、互联网数据服务的特点
互联网数据服务通常具备以下特征:
- 数据量大:日增数据可达TB甚至PB级别。
- 实时性要求高:如推荐系统、风控、监控等场景需要秒级响应。
- 服务链条长:涉及数据源、消息队列、计算引擎、存储、查询引擎等多个环节。
- 用户规模大:高并发访问对系统稳定性提出严峻考验。
三、大数据运维的核心任务
- 集群管理与监控:
- 部署和维护Hadoop、Kafka、HBase、ClickHouse等集群。
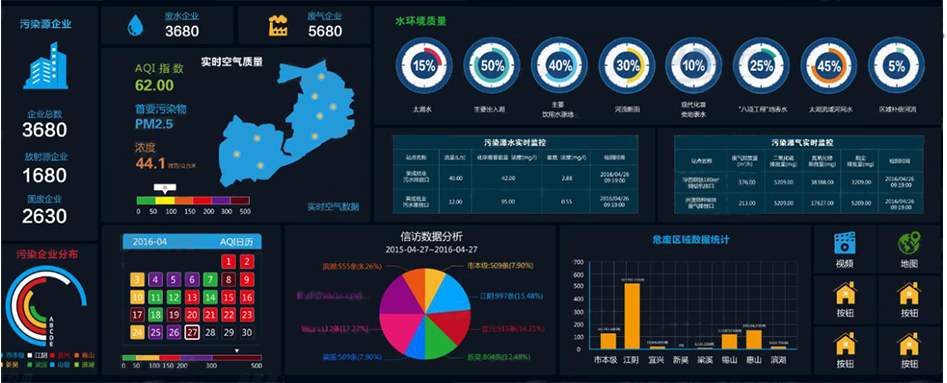
- 使用Prometheus、Grafana、Zabbix等工具监控资源使用率、任务延迟、节点健康状态。
- 性能优化:
- 调整参数(如YARN内存分配、Spark并行度)以提升作业效率。
- 优化数据分区、索引和压缩策略,减少I/O开销。
- 故障排查与恢复:
- 快速定位节点故障、数据倾斜、作业失败等问题。
- 制定应急预案,实现自动故障转移和快速恢复。
- 数据安全与权限管理:
- 通过Kerberos、Ranger等实现认证和授权。
- 定期备份元数据和关键数据,防止丢失。
- 成本控制:
- 合理规划资源,避免过度配置。
- 采用弹性伸缩和混部技术降低云成本。
四、面临的挑战
- 复杂性高:组件众多,版本兼容性和依赖关系复杂。
- 数据倾斜:导致个别任务拖慢整体作业。
- 实时与离线并存:需要同时保障流处理和批处理的稳定性。
- 人才短缺:既懂大数据技术又懂运维的复合型人才稀缺。
五、最佳实践
- 自动化运维:利用Ansible、Terraform等实现基础设施即代码,减少人工干预。
- 建立SLA体系:明确服务等级目标,如数据延迟不超过5分钟,可用性99.9%。
- 变更管理:任何配置变更需经过测试和灰度发布。
- 容量规划:基于历史数据预测未来资源需求,提前扩容。
- 文档与知识沉淀:记录常见问题解决步骤,形成运维手册。
六、未来趋势
随着云原生和AI技术的发展,大数据运维正朝着智能化、Serverless化方向演进。AIOps可通过机器学习预测故障和自动调优;Serverless架构让运维人员更关注业务逻辑而非底层资源。数据湖仓一体、流批一体等新范式也将对运维提出新要求。
###
大数据运维是互联网数据服务的基石。只有通过精细化、自动化和智能化的运维管理,才能确保数据服务在激烈竞争中保持稳定、高效和低成本。企业应重视运维团队建设,持续引入新技术,以应对日益复杂的数据挑战。
如若转载,请注明出处:http://www.hulgljd.com/product/35.html
更新时间:2026-09-21 10:46:47